The función de verosimilitud es un concepto muy utilizado y fundamental en la estadística y el aprendizaje automático, ya que permite estimar los parámetros de un modelo a partir de los datos observados.
In the context of the artificial intelligence (AI), su aplicación es necesaria para lograr el ajuste de modelos predictivos, la inferencia bayesiana y la selección de hipótesis en problemas de clasificación y regresión.
Qué es la función de verosimilitud y cómo se aplica en la IA
La función de verosimilitud cuantifica la probabilidad de observar un conjunto de datos dado un conjunto de parámetros del modelo.
Matemáticamente, si un conjunto de datos X = { x1, x2, …, xn } sigue una distribución de probabilidad con parámetros θ, la función de verosimilitud se define como:
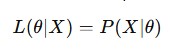
En la IA y el aprendizaje automático, esta función se utiliza para encontrar los estimadores de máxima verosimilitud (MLE, Maximum Likelihood Estimation), que optimizan los parámetros para maximizar la probabilidad de los datos observados.
Ejemplos prácticos en aprendizaje automático
En aprendizaje automático, la función de verosimilitud se utiliza para la estimación de parámetros en diversos modelos. Algunos ejemplos podrían ser:
- Logistic regression: se emplea la verosimilitud para ajustar los coeficientes del modelo optimizando la función log-verosimilitud.

 Español
 English (UK)